最近需要系统化整理下 MCP、Agent,以便融入到当前多模型聊天产品中,于是先从 MCP 开始。既然是 Claude 定义的,先看看 Google 和 OpenAI 是如何定义的。
MCP 不是魔法,而是管道,优秀的管道。它负责处理那些乏味的工作如发现、路由、序列化。
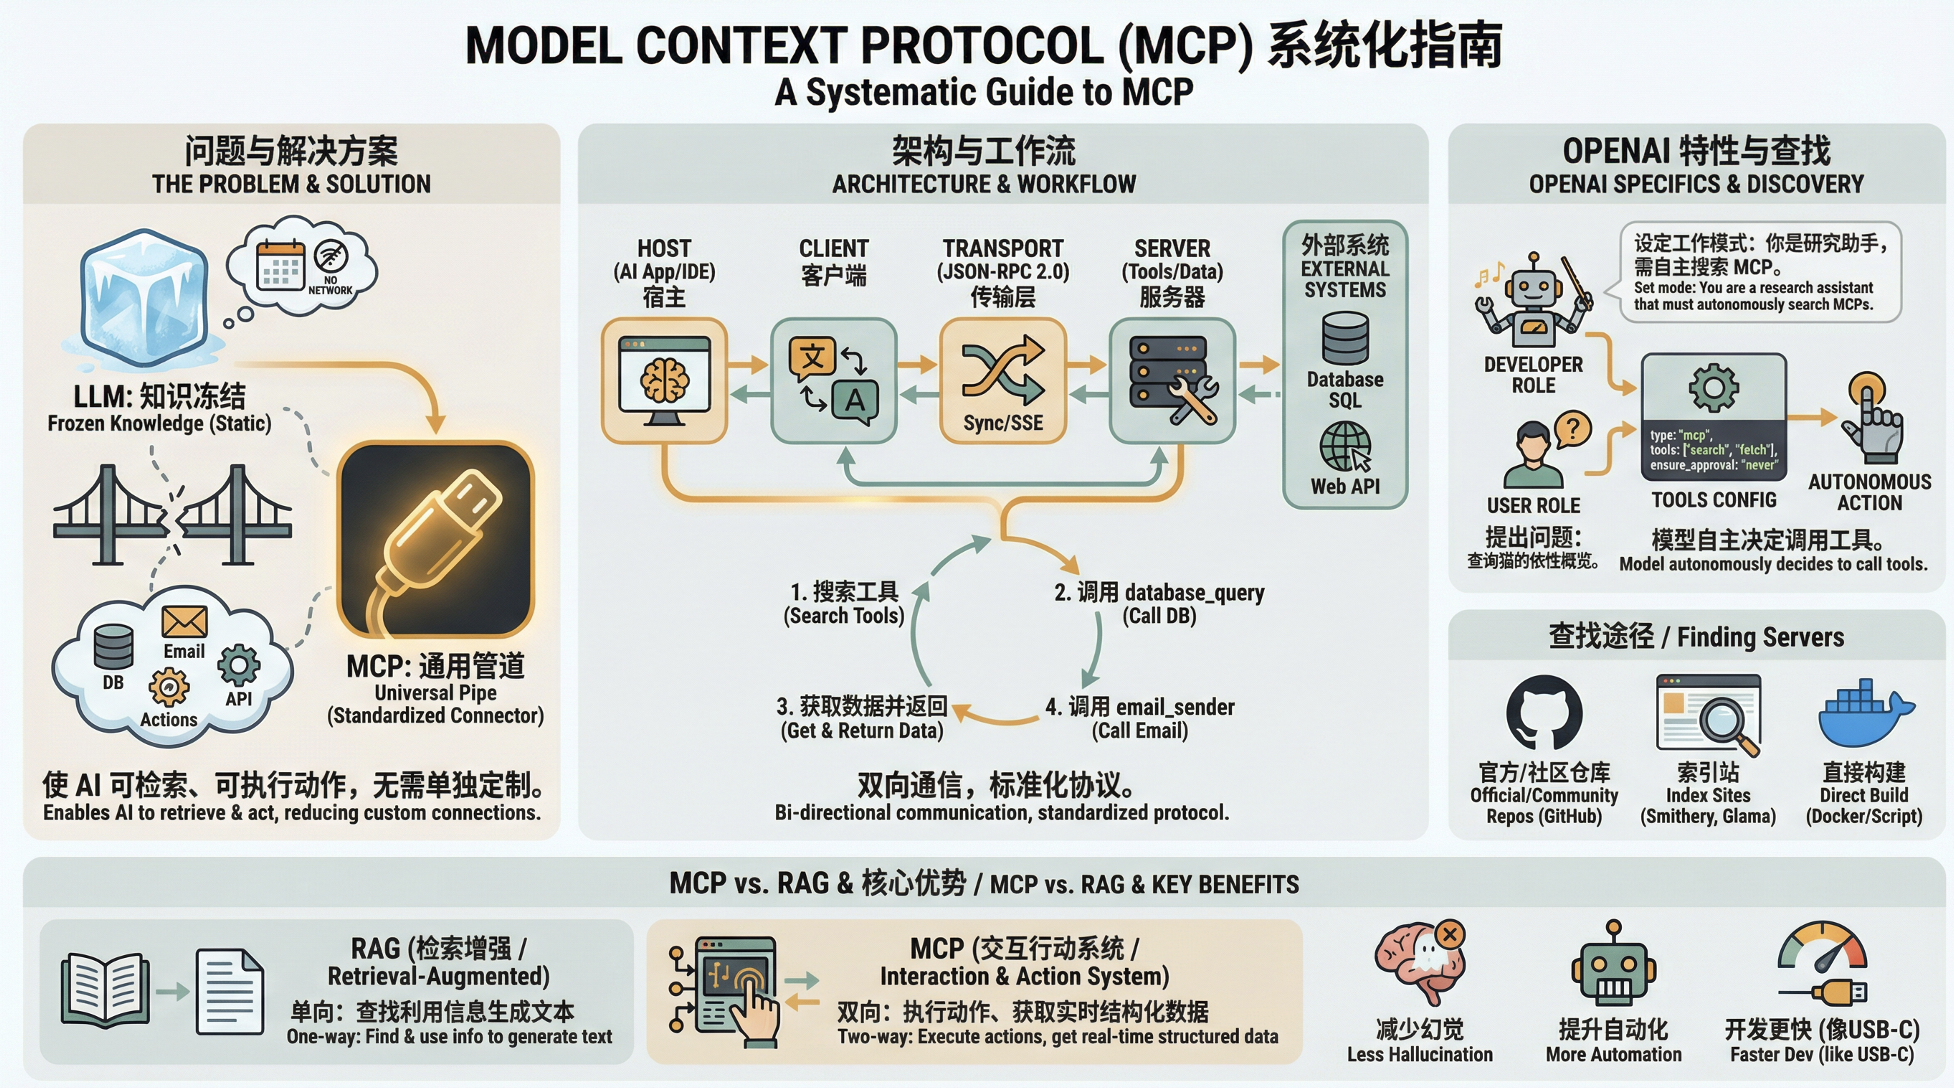
LLM:Their knowledge is frozen at the time of their training, and they can’t interact with the outside world. This means they can’t access real-time data or perform actions
- 订会议室
- 发邮件
- ….
Anthropic 于 2024 年 11 月推出 MCP 协议,目的是使 AI 能够突破静态知识的限制,可检索、可执行动作。于是2024 年开始,MCP 的出现,是基于现有的工具使用和函数调用等概念,并对其进行了统一规范,从而减少了为每个新的 AI 模型与外部系统单独开发定制连接的需求。
包含了四层: host / client / server / Transport layer
Host:MCP 宿主可以是 AI 应用或环境,例如 AI 驱动的集成开发环境(IDE)或对话式 AI。它通常是用户的主要交互界面。host代表会调用 LLM 处理可能需要外部数据或工具的请求。 客户端: 将 LLM 发出的请求转换为符合 MCP 协议的格式,并将 MCP 的响应转化为 LLM 可理解的内容。 server:提供上下文、数据或功能的外部服务。它通过连接数据库、Web 服务等外部系统,将这些系统的响应转换为 LLM 可理解的格式,从而帮助开发者为 LLM 实现多样化的功能。 Transport layer:通过 JSON-RPC 2.0 消息在客户端与服务器之间进行通信 - 同步的消息传输 - SSE 实时数据流传输
场景以查询销售数据,然后报告发给我为例: 1.LLM 无法访问 db,通过 MCP 客户端搜索可用工具,发现两个相关工具已在 MCP 服务器上注册:database_query 工具和 email_sender 工具。 2.工具调用,首先调用 database_query 工具获取数据。Client 将该请求发送到 Server 3.MCP Server,收到请求,转换为安全 SQL 查询,然后获取数据。处理好数据返回给 Client 的 LLM 4.LLM 调用 email_sender 工具,发送 邮箱地址和报告内容
MCP 与 RAG 的区别:
- RAG 用于查找并利用信息生成文本
- MCP 是一个更广泛的交互与行动系统。
MCP :
- 双向通信机制,使其能够访问并交互外部工具、数据源和服务,在信息检索的同时执行各类操作。
- 有一套标准化协议,用于调用外部函数或从专用服务器获取结构化数据,从而实现操作执行与动态上下文集成。
- AI 智能体执行任务(如预订航班、更新 CRM、运行代码)、获取实时数据、进行高级集成。
减少幻觉现象 / 提升自动化能力 / 更快(MCP 提供了一个通用、开放的标准,使这些连接更为便捷,就像 USB‑C 接口让设备连接更简单一样。这种精简方式能够降低开发成本,加快 AI 应用的构建进度)
MCP 的重要价值在于它可访问的工具。您可以将 LLM 连接到各种内外部数据等任务上: 数据库 / bigquery /
openai
如何构建远程 MCP 服务器,从私有数据源(如向量存储)读取数据,并通过连接器在 ChatGPT 的对话、深度研究以及 API 中向用户提供这些数据 1.可以使用 Python 和 FastMCP 搭建 MCP 服务器。 显然可以有多种 MCP 服务器框架可供选择 2.要在 ChatGPT 连接器或深度研究(无论是在 ChatGPT 内还是通过 API)中使用,MCP 服务器必须实现两个工具:search 和 fetch。
search tool:
根据用户查询,从 MCP 服务器的数据源结果。必须以内容数组(content array)的形式返回,包含一个或多个内容项。返回格式: id - a unique ID for the document or search result item title - human-readable title. url - canonical URL for citation.
{ “content”: [ { “type”: “text”, “text”: “{"results":[{"id":"doc-1","title":"…","url":"…"}]}” } ] }
fetch tool
同样,fetch 工具的返回结果必须以内容数组的形式提供 { “content”: [ { “type”: “text”, “text”: “{"id":"doc-1","title":"…","text":"full text…","url":"https://example.com/doc","metadata":{"source":"vector_store"}}” } ] }
如何访问这些 tools 呢?Openai 给出了下边这个访问示范。 以前,在提示词的世界中,和模型互动通常是通过输入自然语言或结构化提示,模型在自己的知识库(权重)和上下文中直接生成回答。 现在,MCP 类似于插件系统”或工具调用机制,但更加标准化和可扩展。那么 MCP 会告诉我们有哪些外部工具可用、如何调用、返回什么数据、由谁控制调用权限等。模型可以在推理中动态决定访问某个 MCP server(数据源或功能模块),并接收实时的数据去增强上下文。
那么我们详细分析下这个官方示例为代表的逻辑:
curl https://api.openai.com/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
  "model": "o4-mini-deep-research",
  "input": [
    {
      "role": "developer",
      "content": [
        {
          "type": "input_text",
          "text": "You are a research assistant that searches MCP servers to find answers to your questions."
        }
      ]
    },
    {
      "role": "user",
      "content": [
        {
          "type": "input_text",
          "text": "Are cats attached to their homes? Give a succinct one page overview."
        }
      ]
    }
  ],
  "reasoning": {
    "summary": "auto"
  },
  "tools": [
    {
      "type": "mcp",
      "server_label": "cats",
      "server_url": "https://777ff573-9947-4b9c-8982-658fa40c7d09-00-3le96u7wsymx.janeway.replit.dev/sse/",
      "allowed_tools": [
        "search",
        "fetch"
      ],
      "require_approval": "never"
    }
  ]
}- 用 curl 进行请求 openai,带上 header 和认证
- 模型使用 o4-mini-deep-research,模型会先根据提示词判断是否需要访问 MCP server,然后再综合信息输出。
- 不一样的地方来了:“role”: “developer”,这段内容其实是告诉模型:你的工作模式是研究助手,你必须通过 MCP server 搜索答案,而不是只用已有知识。
- 用户真正的研究问题:猫是否会依恋自己的住所?要求简洁的一页概览。
- 模型将此问题作为任务输入,在研究助手模式下,决定如何搜索相关信息。
- Reasoning 配置 auto,意味着:模型可以自动在响应中生成推理摘要,不需要手动定义。
- MCP 工具配置:“tools”: […]
- type: “mcp” 指定这是 MCP 协议工具,而非内置函数。
- server_label: “cats” 给这台 MCP server一个标签
- server_url: MCP server 的 SSE 地址,用于双向通信
- allowed_tools: [“search”, “fetch”] 明确告诉模型:这个 MCP server中,你可以使用两个工具
- search:输入关键词,得到相关资源或信息列表
- fetch:根据资源 ID 或 URL 拉取具体内容
- require_approval: “never” 表示模型调用 MCP 工具不需要用户额外确认
所以,MCP 是提示词之外的另一个上下文注入方式。它不通过 prompt 塞数据,而是让模型自己去API 调 MCP server,然后再把收到的数据放入自己的上下文。这是自动化外部信息检索的一部分。
模型角色有明确分层:
- developer 角色定义工作模式和工具使用范围。
- user 角色提出具体问题。
工具调用是模型自主决定的(根据 developer 提示和 user 问题),在这个调用中完全不需要用户交互。
server_label + allowed_tools 是把外部数据源和接口能力“挂载”到模型的工作环境,相当于给模型装备了一套专用 API。
那么这个示范调用实现的逻辑是:
定义模型工作模式:研究助手,可以访问 MCP。
指定问题:猫是否依恋住所,一页概览。
挂载 MCP server:连接到一个猫主题的外部数据服务,提供搜索与获取能力。
运行过程:模型分析问题 → 调用 MCP 工具 → 拿到数据 → 综合生成回答。
优势:比单纯 prompt 更精准可靠,因为模型直接消费来自外部实时或专业数据源的内容。
写在最后
目前 MCP 还在早期爆发阶段,以下优先级查找:
途径一:官方和社区仓库 (最推荐) Anthropic 的官方仓库包含了你提到的所有类型的参考实现,且大部分都提供了 Dockerfile。
GitHub: model-context-protocol/servers
途径二:MCP 专属索引站 (最方便) 这些网站专门收集 MCP Server,并且会直接给出 Docker 运行指令。
- Smithery (smithery.ai): 目前最全的索引站,支持一键获取 Docker 配置。
- Glama (glama.ai/mcp/servers): 另一个高质量的目录。
途径三:直接构建 很多 MCP Server 本质是 Python 或 Node.js 脚本。如果官方没推 Docker 镜像,直接用通用 Python/Node 镜像挂载脚本运行往往更稳定。
讨论
登录后可评论、点赞、引用回复。