金融 RAG 最危险的地方,不是它完全答错。而是它只答对了一半。
客户问:“意外住院能报销多少?” AI 很快回答:“最高赔付 10 万。”
听起来没问题,因为条款里确实写了最高 10 万。但它漏掉了下一段:必须在事故发生后 30 天内提交完整病历和诊断证明。这时候,答案就从“有用”变成了“危险”。
再比如,销售人员问:“这个贷款产品年利率是多少?” AI 回答:“年利率 3%。” 也没错,宣传材料里确实这么写。但它没有带出后面的限制条件:仅限优质信用客户,可能还需要购买附加保险。
所以金融 RAG 里真正难的,不是让 AI 找到一句话,而是让 AI 找到“完整的业务条件”。额度、条件、限制、例外、版本、权限、适用对象,必须一起被找到。
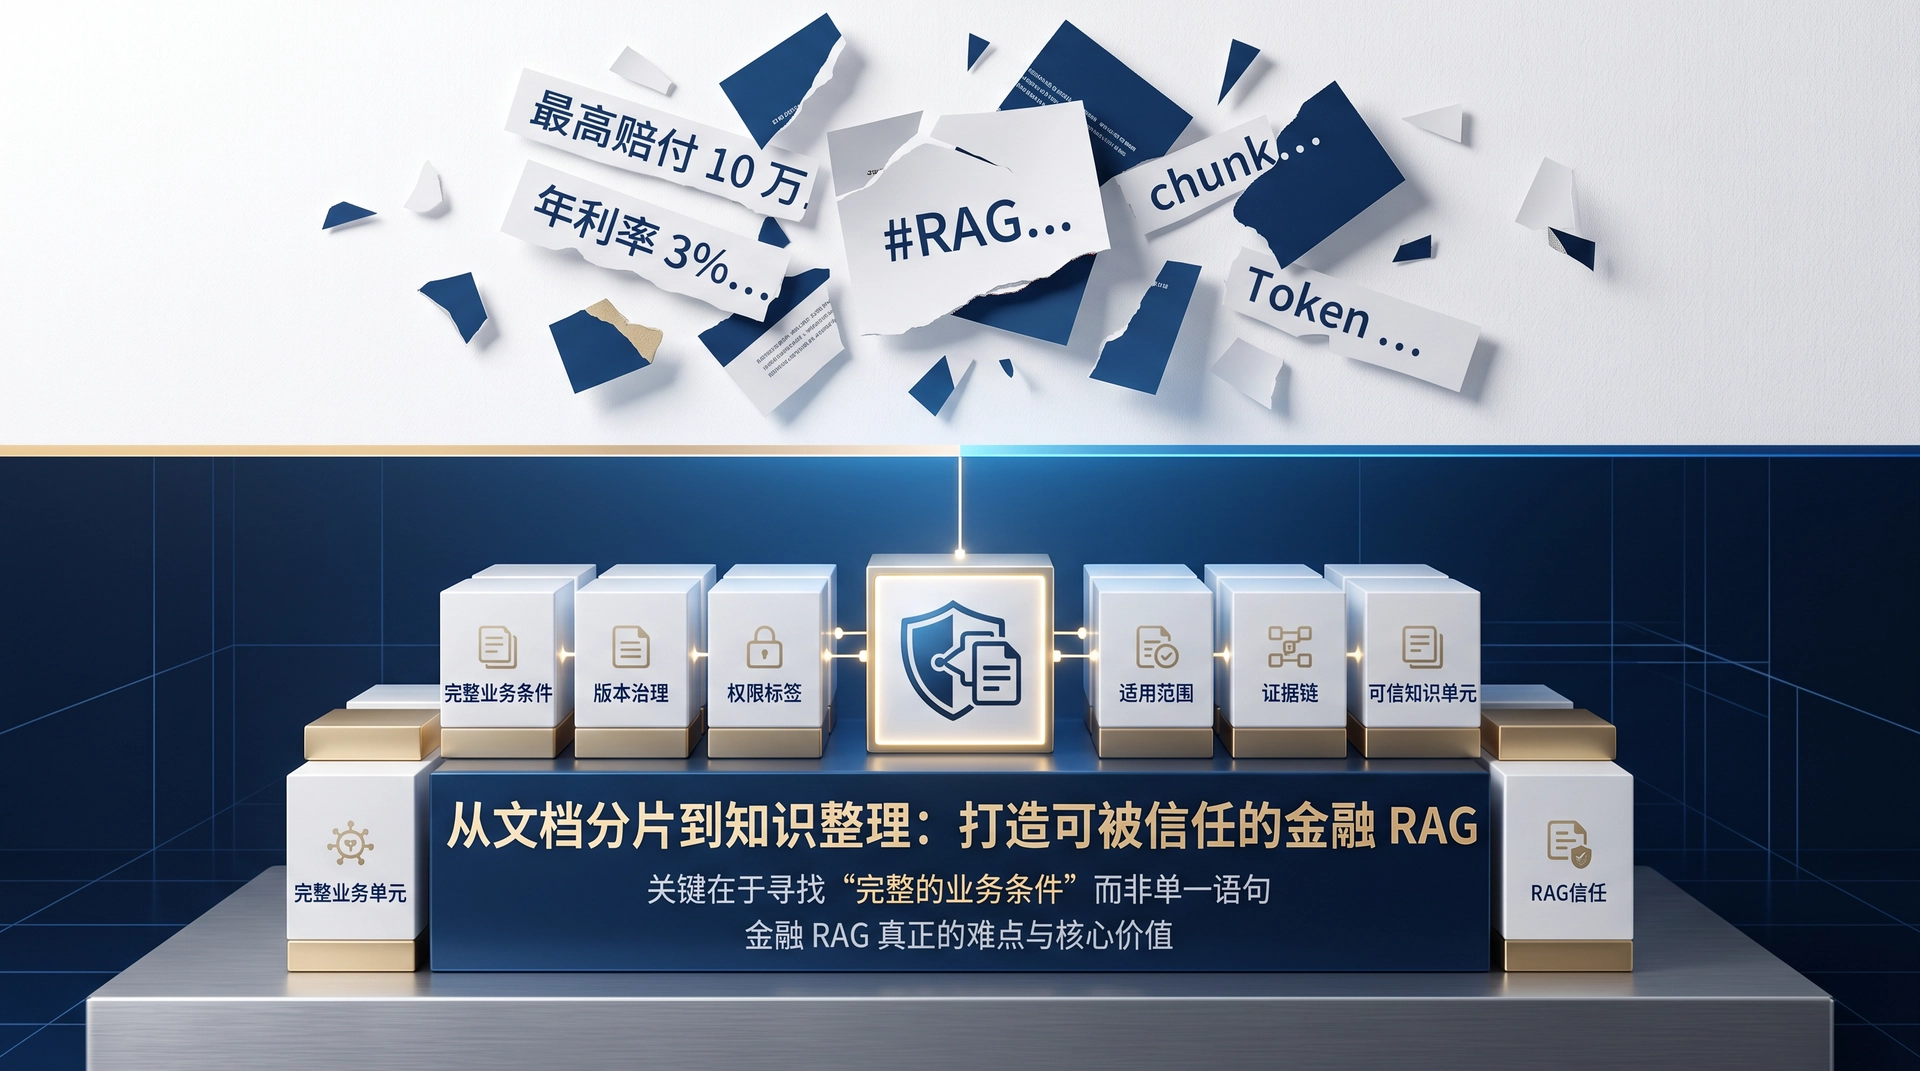
这就是为什么我们讲完第一层文档接入之后,第二层一定要讲文档分片。
但“分片”这个词其实有点误导。很多人一听分片,就以为是把一篇长文档切成很多小段。比如每 500 个 token 切一块,每块重叠 100 个 token,然后丢进向量库。这就是早期很多 RAG 系统的做法。
流程也很简单: 上传文档。 切成 chunk。 做 embedding。 用户提问时召回 TopK。 最后塞给大模型生成答案。
这个流程看起来非常合理,甚至很多低配版 RAG 都是这么搭起来的。
问题是,金融文档不是普通文章。金融文档里的关键信息,往往不是孤立存在的。 一句“最高赔付 10 万”,后面可能跟着申请条件。 一个“年利率 3%”,旁边可能有适用客户。 一个产品说明,可能有新旧版本。 一个表格里的数字,可能要结合表头、脚注、单位和适用地区才能理解。 一个合规要求,可能只适用于某类客户、某个地区、某个时间范围。
如果你只是按长度把文档切开,就很容易把“结论”和“条件”切断,把“正文”和“表格”切断,把“条款”和“例外”切断,把“当前版本”和“历史版本”混在一起。于是系统上线后就会出现一堆问题。
文档明明上传了,AI 却找不到。 模型给了引用,但引用内容和答案对不上。 表格明明在文档里,AI 却理解错了。 回答东拼西凑,看起来很流畅,实际上缺少关键上下文。 更严重的是,它可能用了过期版本,或者用了当前用户根本没有权限查看的信息。 最后答案看起来像专家,仔细一看却非常不可靠。
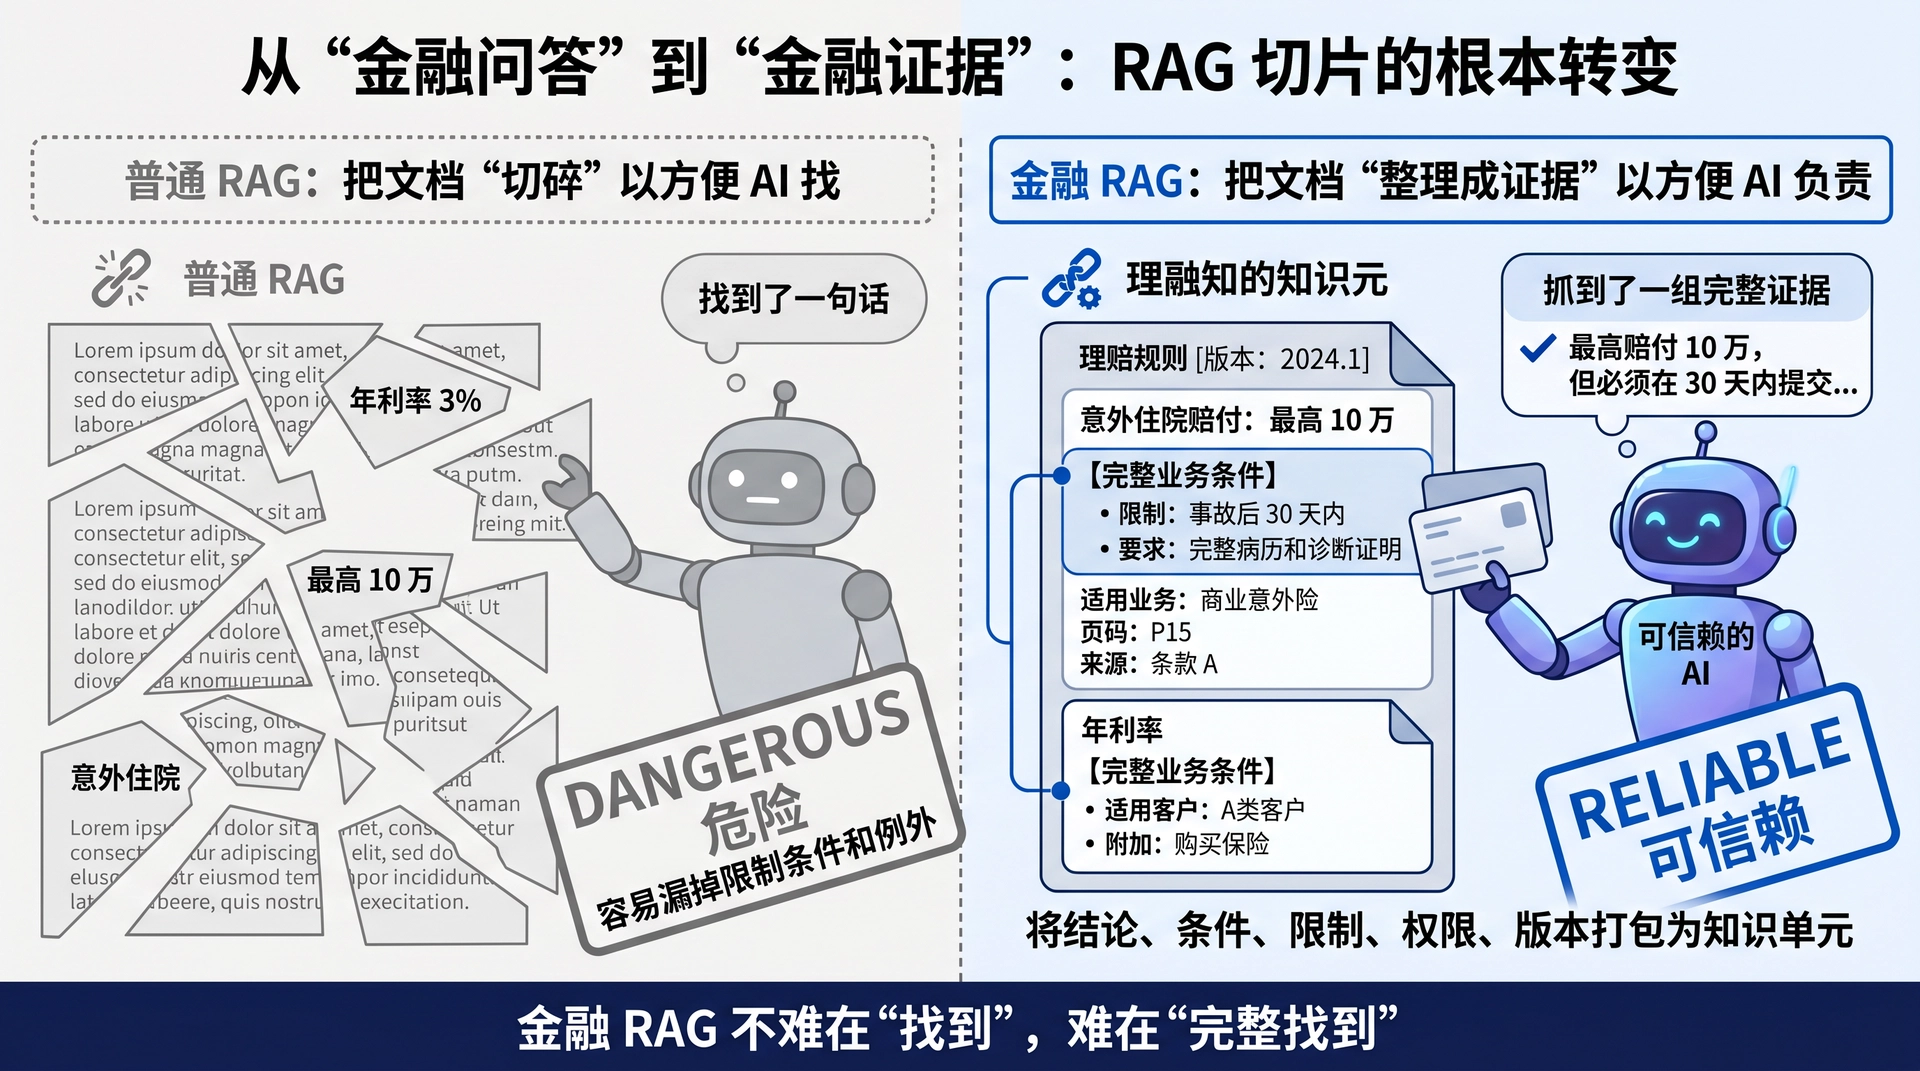
所以,金融 RAG 里的文档分片,不是简单切文本。它更接近“知识整理”。
也就是说,系统要把一份复杂文档,整理成一个个可以被检索、可以被理解、可以被引用、可以被追责的知识单元。 这个知识单元不只是正文。它还要带着标题、章节、页码、表格位置、文件来源、版本号、生效日期、失效日期、权限标签、适用业务、适用客户、上下文关系。
这样 AI 在回答问题时,才不是只抓到一句话,而是抓到一组完整证据。 早期向量库为什么经常被骂?不是因为向量检索没用,而是因为很多系统把 RAG 做得太粗。
过去常见的做法是:一份文档进来,直接按固定长度切块,然后把每个块向量化。用户一提问,就找相似度最高的几个块。再把这些块塞给大模型,让它生成答案。
这个方法在简单知识问答里可以跑起来,但到了金融场景就很容易出问题。因为金融问题不是单点信息匹配,而是条件组合。
客户真正问的不是“文档里有没有这句话”。 客户问的是:“在我的情况里,这条规则到底怎么适用?” 这就要求系统必须同时找到主条款、限制条件、例外条款、最新版本和可信引用。 所以现在更好的 RAG 分片策略,已经不是固定 token 分块,而是结构感知、语义感知、业务感知和评测驱动的组合。
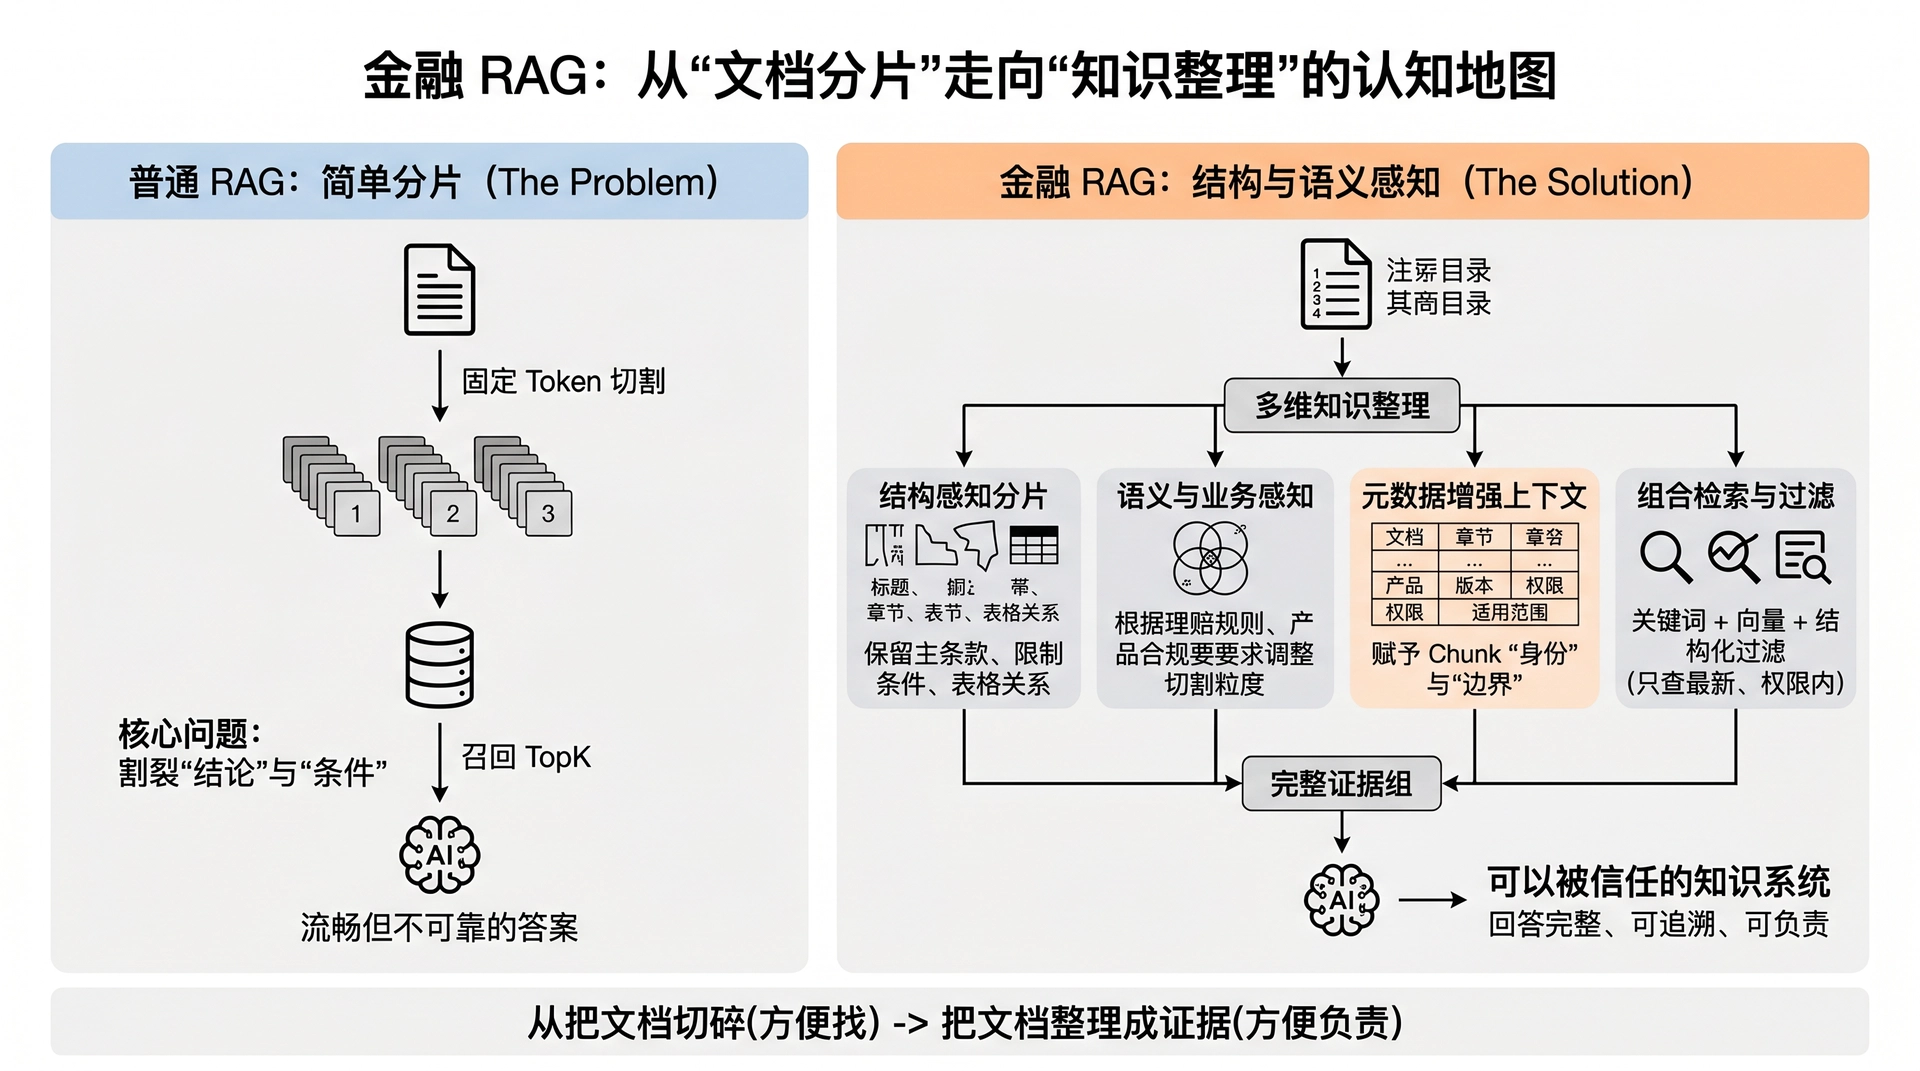
第一步,要先看文档结构。 标题是什么? 章节怎么分? 表格在哪里? 脚注在哪里? 图片和公式有没有业务含义? 这一段属于哪个产品,哪个版本,哪个页面?
第二步,要根据业务问题来决定怎么切。 如果是产品简介,可以切得稍微大一点。 如果是合规条款,要尽量保留完整条件。 如果是表格,需要把表头、单位、行列关系和脚注一起保住。 如果是理赔规则,就不能把赔付额度和申请条件分开。
第三步,要给每个 chunk 加上下文。 比如这个 chunk 来自哪份文档,属于哪个章节,适用于哪个产品,当前是不是最新版本,能不能被这个用户访问。 没有这些上下文,AI 看到的只是一小段孤立文字。 有了这些上下文,它看到的才是一块有身份、有位置、有边界的知识。
第四步,要做组合检索。 不能只靠向量相似度。 有些问题适合关键词召回,比如产品编号、条款名称、客户类型。 有些问题适合语义召回,比如用户用口语表达一个复杂业务问题。 有些问题需要结构化过滤,比如只查最新版本,只查某个地区,只查某个部门有权限看的内容。 所以更可靠的系统,往往是 BM25、向量检索、元数据过滤、重排序、甚至图谱关系一起用。
第五步,要用评测反过来优化分片。 不要凭感觉说“这套分片策略不错”。 要看真实问题能不能命中关键证据。 要看答案有没有漏掉限制条件。 要看引用是否准确。 要看有没有误用过期版本。 要看业务人员是否敢用。 如果评测发现,理赔问题经常漏掉申请材料,那就说明分片策略没有把条件保住。 如果贷款产品经常漏掉适用客户,那就说明 chunk 的上下文不够。 如果引用经常对不上,那就说明页码、章节、锚点没有处理好。
所以,文档分片不是一个小技术点。 它决定了金融 RAG 到底是在做“看起来聪明的搜索”,还是在做“可以被信任的知识系统”。 你可以这样理解: 普通 RAG 是把文档切碎,方便 AI 找。 金融 RAG 是把文档整理成证据,方便 AI 负责。 这两者差别非常大。
一个优秀的金融 RAG 系统,最后看起来好像是 AI 在回答问题。 但背后真正决定质量的,往往是这些看不见的工作: 文档有没有解析对。 表格有没有还原对。 章节有没有保住。 版本有没有治理。 权限有没有过滤。 chunk 有没有带上上下文。 检索有没有召回完整证据。 引用有没有落到准确位置。
这也是为什么很多 AI 项目最后不是败在模型不够强,而是败在知识没有整理好。模型越强,越容易把残缺的信息讲得像真的。
所以在金融场景里,真正可靠的 RAG 不是让 AI 自由发挥。而是让 AI 在一套可治理、可追溯、可评测的知识结构里工作。
这就是从“文档分片”走向“知识整理”的核心变化。
讨论
登录后可评论、点赞、引用回复。