AI 时代真正的分水岭,不是模型会不会聊天,而是它什么时候进入生产自身的循环;当 AI 执行的成本被打到极低,人类最稀缺的能力就会从亲手完成任务,转向定义目标、判断结果、建立信任和承担责任。
我们今天来看看 Anthropic 前段两天发了一篇博客,看似是对这大半年了 AI 发展的一个总结。
第一段:AI 正进入 AI 研发链条自身,影响的是所有行业。 文章开门见山地提出 AI 自循环,也就是 AI 正在冲向自我迭代升级,而且说这种情形或将很快的速度降临!然后笔锋一转,说到工程师平均每季度交付的代码量已达到 2021–2025 年期间的 8 倍。你看像极了用显微镜观察自己的细胞,这AI 企业自己内部研发链条本身的变化,也是最早、最扎实、最容易展示的内部证据。
第二段:证据来自三个层面,任务时长变长、工程 benchmark 完全解决、Anthropic 内部代码和实验工作被 Claude 接管。
AI 具备执行能力后,立即协助在科学、医疗等领域指数级跃升。当然问题也随之而来的就是如何监控、引导 AI 的行为就至关重要了。这时可以回顾下 AI 的发展:
- 2023 年前,一切依旧。
- 2025 年前,聊天机器人,撰写简短代码,一些文本。
- 2025–2026,自助写代码和修改文件。如今,完成耗时数小时的任务。
- 未来,AI 自行迭代。
为什么会有这个估计,Anthropic 从实际数据出发推演模型每四个月就能把完成任务时长增长一倍。时长是啥意思?意味着任务的复杂程度。而 2026 年前是七个月翻一番。
2024 年 3 月,Claude Opus 3 能够完成的软件任务,其人类耗时仅约 4 分钟。 第二年,Claude Sonnet 3.7 即可胜任需要耗时约程序员一个半小时的任务。 2026 年 5 月,Claude Opus 4.6 已经可以处理长达 12 小时的任务。(AI的进化速度已超越摩尔定律)
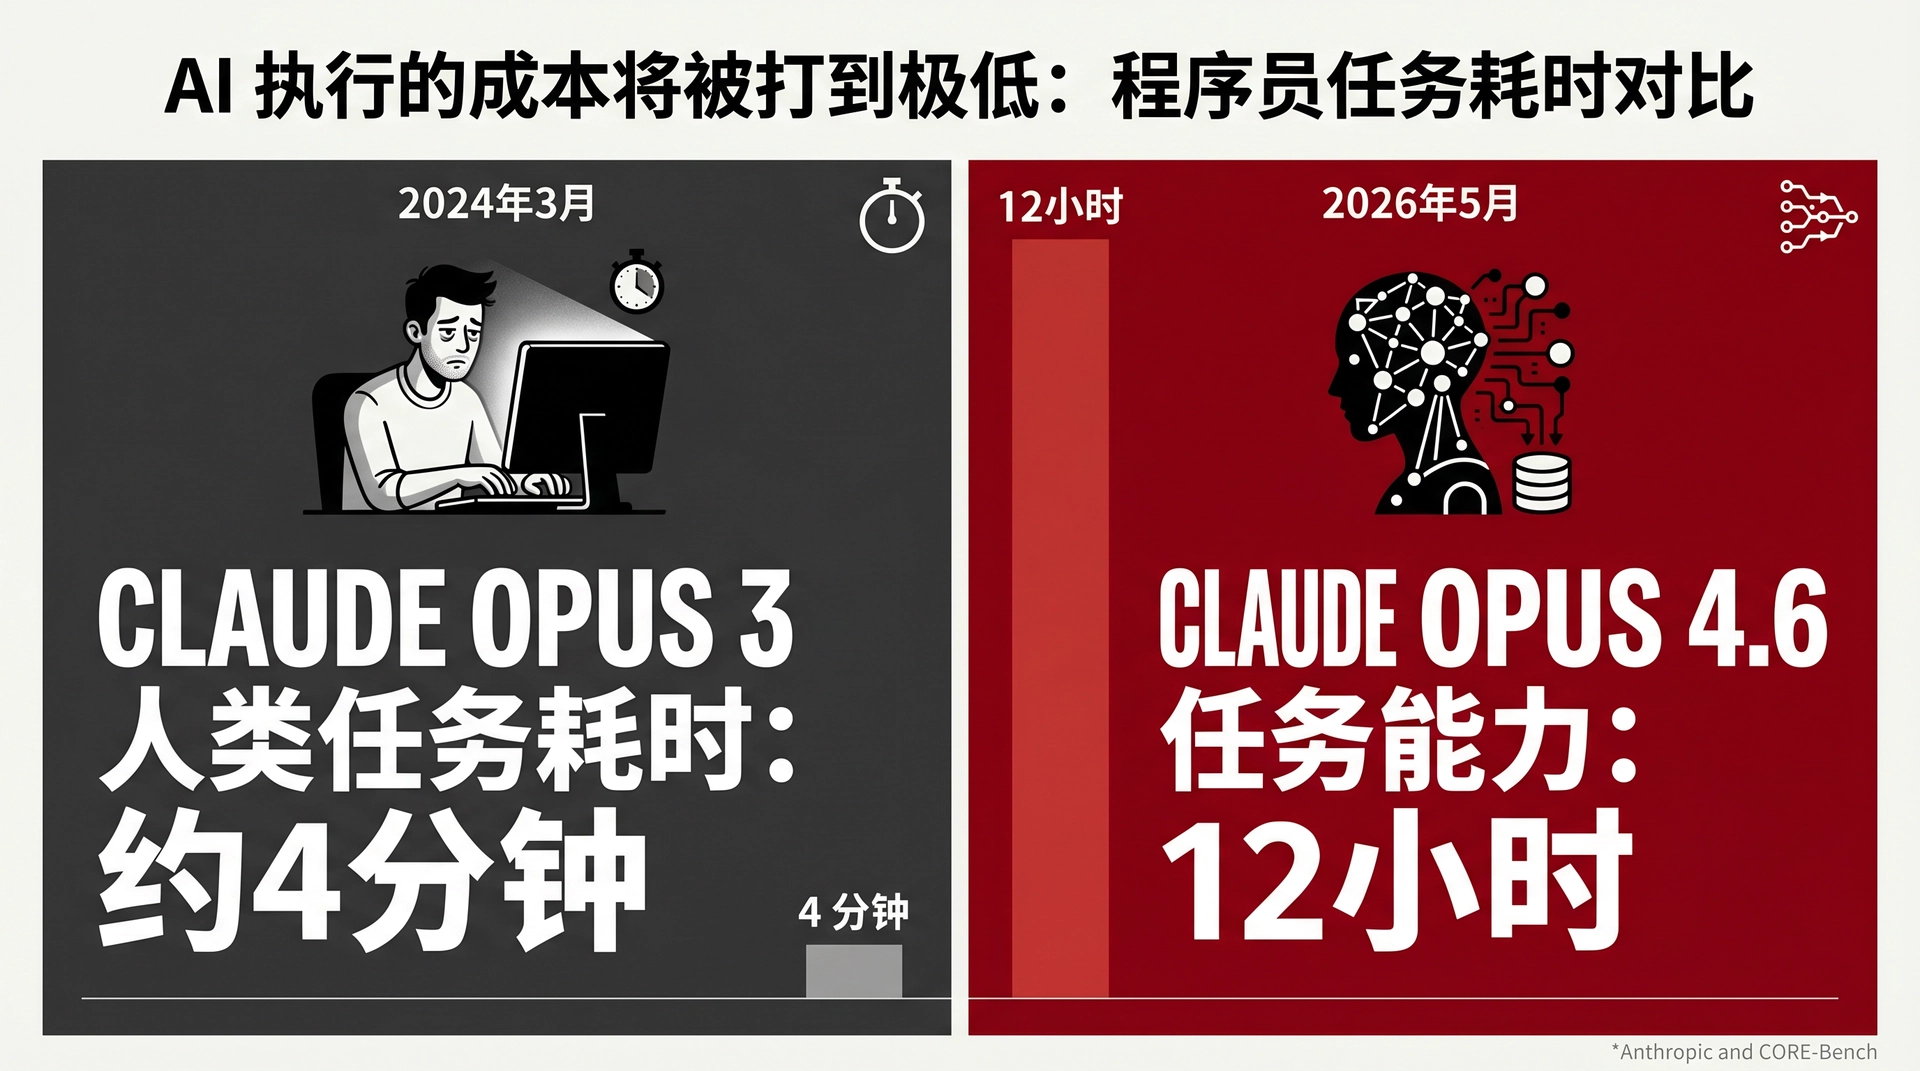
编码和科研上也发展迅速。
在两年前,面对 SWE-bench,顶尖的大模型也只能拿到 1%~4% 的惨淡分数,进展缓慢。
当下呢?模型在这项测试中拿到了接近满分成绩。这意味着,在有明确 issue、真实代码库和测试反馈的工程任务中,模型已经不再只是写小片段,而是开始具备端到端修复问题的能力:读代码、理解 bug、修改文件、运行测试、继续 debug。
当然,感觉在这里谈的历史反战略显荒诞,这才 2 年不到的时间跨度而已,然而在 AI 的发展眼光中,这就已经属于历史。当从后视镜往后一看时,仿佛在看倒放的快进录像,才几个月的 Vibe Coding 给我们带来的冲击是如此之大。从编程干活,到内心焦虑。AI 自己是跑的如此之快。不要再用两年前的眼光低估 AI 对遗留代码、测试体系和工程上下文的理解能力。
再看看 CORE-Bench 呢?这个普林斯顿大学等机构用来评估 AI “能不能复现人类已发表的科学研究”,从 2024 年开始到现在,在有代码、有数据、有明确目标的科研复现场景里,AI 从频繁报错变成了能稳定完成,这可是只用了一年多。那可真是流光容易把人抛,红了樱桃,绿了芭蕉。
Anthropic 内部的证据表明了几个关键点:在科研领域,目标明确的任务显然已经超过人类。当然也不用神乎其神,至少当前AI 的方向感知能力确实极其薄弱。现在最好的使用方法,就是:你给他方向,他自己思考如何解决。
第三段:最关键的边界是执行与判断。AI 已经强在执行层,正在逼近局部判断层,但尚未完全拿下方向设定层。 当然如果仅仅停留于此,那就是很普通的一个介绍而已。文中还讨论了一个更深层次的问题:AGI 是否会带来全面失控的标志:自主决策与目标设定能力。
首先,大家训练的 AI 如此聪明,为什么却在方向选择、科学品味和价值观上没办法展示出更好的能力?
显然,解决问题可以通过查找最短路径,高并发执行以及强化学习达到目的
但是目标的选择呢?至少人类的目标是多重因素决定的,譬如价值判断、直觉和审美。
是吧,Claude 在某些明确任务上,譬如代码质量、代码 review、实验优化上快速接近或超过人类。更多时候是你提出想法,而模型能以比过去快一个数量级的速度去实现、测试和评估这些想法。
譬如有一个开放式 AI 安全研究。在提出问题和评分标准后,agent 累计运行约 800 小时,花费约 18000 美元算力,恢复了弱监督与理想上限之间 97% 的性能差距。作为对比,两位人类研究员大约用一周时间恢复了 23%。
AI 的能力正在从执行层,冲向判断层。写代码时,下一步该往哪里查,模型训练为什么崩了?这一大堆问题没有标准答案,但每天都在用。
而且,Anthropic 又给出了在 129 个人类容易出错的场景,他们发现:在一些真实、困难、且人类确实容易走错的局部判断点上,新模型越来越能提出更好的下一步。 而且另一个数据也挺有趣,在另一个 127 个“人类下一步本来就很强”的问题上,模型建议只有约 20% 被评为更好。
那么未来普通人和高手的差距,不是“会不会用 AI 写东西”,而是“能不能提出值得 AI 去推进的问题”。 也就是说:用户定义问题边界,AI 并行跑多个调查分支,人类审核证据,选择下一轮方向。 这是当下使用 AI 人员仅剩的作用,把握全局,并跳出眼前任务的局限进行思考。
虽然此时此刻,人类使用 AI 的作用依然正在被一层一层蚕食,被 Claude 为代表的 AI 冲击得所剩寥寥。
第四段:真正的问题不仅是担忧自我进化是否明天到来,而是当执行成本趋近于零,个人和组织的新瓶颈是什么。我认为答案是目标、判断、信任、验证、协调。
这个曾经我们期待的自动驾驶,人类显然正在退居后排。
这里提出了几个最关键的问题: 你是否还理解我让 AI 做了什么? 你是否还能判断它做得对不对? 你是否还能在它失败时接管? 你是否还有真实的人与人之间的协作?
这很震撼,何况今天的 AI 能力 Anthropic 说已经足够改变世界。AI 也势必能够超线性发展,显然未来也将会有更多更大规模自动化。
当下已经是一个想象不到的、伟大的知识爆发时代,对于未来我们更应保持理性的美好期待。
因为在 Amdahl’s law 看来,一个并行计算再快,如同木桶原理那样,最终是最短的那块木板决定了木桶能装多少水,运行速度能跑多快。
AI 可能会把执行的成本打到极低,譬如写代码、做实验、找 Bug。但个体和组织进步速度会受限于哪些“最矮的那一块”。
我们既不能乐观幼稚:AI 一旦超级聪明,所有问题马上解决。 当然更不能末日论:AI 一旦递归自我改进,人类就可以躺平。
故事讲到这儿,也曾仿佛认为未来太危险,我们需要停一停吗? 然而,谁想停,谁又会真的停呢。
开弓之后,确实很难再回头。 然而谁又清楚,这支箭究竟射向何处?
讨论
登录后可评论、点赞、引用回复。