从“reasoning”思维到“agentic”思维
0. 背景与主张:从推理式思维迈向智能体式思维
回顾 o1/R1 推理聚焦,提出下一步为智能体式思维。
背景说明
JunYang Li 在 Twitter 上写出了他最近的感受。原文 :https://x.com/JustinLin610/status/2037116325210829168
过去两年彻底改变了我们评估模型的方式以及对其能力的预期。OpenAI 的 o1 展示了,“thinking” 可以成为一项一流能力——可以专门训练,并直接向用户开放。DeepSeek‑R1 证明了推理式后训练(reasoning‑style post‑training)不仅可以复现,还能在原始实验室之外实现规模化。OpenAI 将 o1 描述为通过强化学习训练,使其能够“think before it answers”的模型;DeepSeek 则将 R1 定位为可与 o1 竞争的开放推理模型。
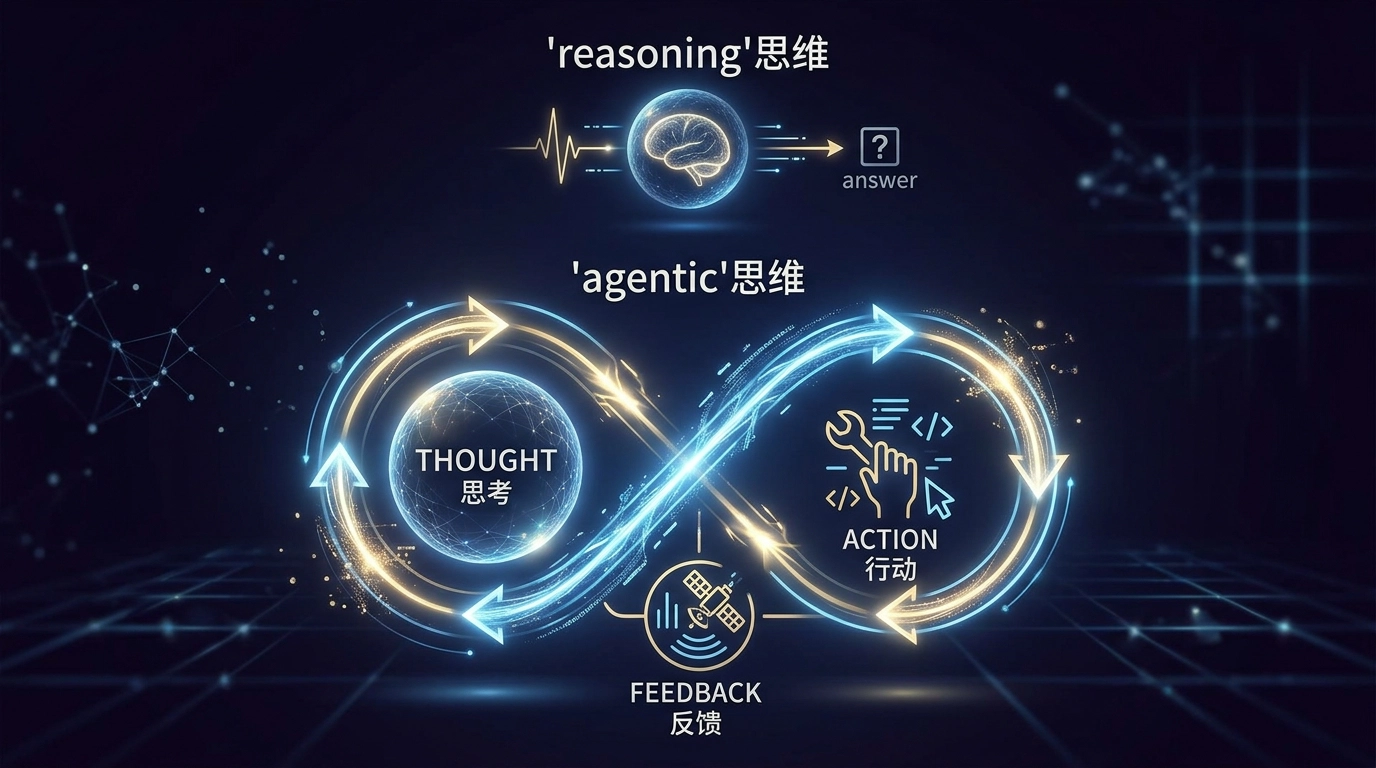
这一阶段意义重大。但 2025 年上半年主要聚焦于“reasoning thinking”(推理式思维):如何让模型投入更多推理时计算(inference‑time compute),如何用更强的奖励信号进行训练,以及如何暴露或控制额外的推理投入。现在的问题是,下一步是什么?我们认为答案是智能体式思维(agentic thinking):即为行动而思考,在与环境交互的过程中,持续根据外部反馈动态更新计划。
我们认为答案是智能体式思维(agentic thinking):即为行动而思考,在与环境交互的过程中,持续根据外部反馈动态更新计划。
1. o1 和 R1 崛起真正教给我们的是什么
推理型 RL 需要强可验证反馈与可扩展基础设施。
背景说明
第一波推理模型让我们认识到,如果希望在语言模型中扩展强化学习(RL),就必须具备确定性、稳定且可扩展的反馈信号。数学、代码、逻辑以及其他可验证领域之所以成为核心,是因为这些场景下的奖励远强于通用偏好监督。这些奖励让 RL 能够优化正确性,而非仅仅优化合理性。基础设施的重要性随之凸显。
系统与基础设施
一旦模型被训练用于更长的推理轨迹,RL 就不再是监督微调(SFT)上的轻量附加项,而是一个系统性问题。你需要大规模 rollout(回放)、高吞吐验证、稳定的策略更新、高效采样。推理模型的出现既是建模故事,也是基础设施故事。OpenAI 将 o1 描述为用 RL 训练的推理线,DeepSeek R1 随后进一步强化了这一方向,展示了推理型 RL 所需的大量算法与基础设施投入。
第一个重大转变是:从扩展预训练到扩展后训练(post‑training)以支持推理。
2. 真正的问题从来不是简单的“合并 ‘thinking’ 与 ‘instruct’”
合并难点在数据分布与行为目标差异。
理想蓝图
2025 年初,我们 Qwen 团队中的许多人心中都有一个雄心勃勃的蓝图。理想的系统能够统一 “thinking” 和 “instruct” 模式,支持可调节的推理投入,类似于 low / medium / high 推理设置。更进一步,系统能自动根据提示和上下文推断所需的推理量,让模型自行决定何时立即作答、何时需要更长时间思考,以及何时在真正困难的问题上投入更多计算资源。
从理念上看,这确实是正确的方向。Qwen3 是最明确的公开尝试之一。它引入了“混合思维模式”,在同一系列中支持 “thinking” 和 “non‑thinking” 行为,强调可控思维预算,并提出了包含 long‑CoT cold start 和推理型 RL 后,显式融合 “thinking” 模式的四阶段后训练流程。
难点与数据
但“合并”远比描述要难得多。
难点在于数据。
当人们讨论合并 “thinking” 与 “instruct” 时,往往首先关注模型侧的兼容性:一个检查点能否支持两种模式,一个对话模板能否切换,两种模式能否在同一服务栈中暴露合适的开关。更深层的问题在于,两种模式的数据分布和行为目标存在显著差异。
在尝试平衡模型合并与提升后训练数据质量和多样性的过程中,我们并没有做到完全正确。在修订过程中,我们也密切关注用户实际如何使用 “thinking” 和 “instruct” 模式。
- 强大的 “instruct” 模型通常因直接性、简洁性、格式合规、低延迟而获得奖励,尤其是在重写、标注、模板化支持、结构化抽取、运营质检等高频高量的企业任务中。
- 强大的 “thinking” 模型则因在难题上投入更多 token、保持连贯的中间结构、探索替代路径、保留足够内部计算以显著提升最终正确性而获得奖励。
关键拉扯与结果
这两种行为特征存在拉扯。
如果合并数据未经过精细筛选,结果往往是两端都平庸:“thinking” 行为变得杂乱、臃肿或缺乏决断力,“instruct” 行为则不够干净、可靠性下降、成本高于商业用户实际需求。
产品策略分化
分离在实践中依然具备吸引力。2025 年后期,在 Qwen3 初步混合框架之后,2507 line 发布了独立的 Instruct 和 Thinking 更新,包括分开的 30B 和 235B 版本。在商业部署中,许多客户仍然需要高吞吐、低成本、强可控的 instruct 行为以支持批量操作。在这些场景下,合并并非显著优势。分离产品线让团队能更专注地解决各自模式的数据和训练难题。
其他实验室则选择了相反路径。
- Anthropic 公开主张一体化模型理念:Claude 3.7 Sonnet 被介绍为混合推理模型,用户可选择普通响应或扩展思维,API 用户可设置思维预算。Anthropic 明确表示,他们认为推理应是一体化能力,而非独立模型。
- GLM‑4.5 也公开定位为混合推理模型,既有 “thinking” 也有 “non‑thinking” 模式,统一推理、编码和智能体能力;
- DeepSeek 后续在 V3.1 的 “Think & Non‑Think” 混合推理中也走向类似方向。
关键问题
关键问题在于合并是否自然。
如果 “thinking” 和 “instruct” 只是共存于一个检查点,却仍表现为两种生硬拼接的个性,产品体验依然不自然。真正成功的合并需要平滑的推理投入谱。模型应能表达多层次的推理强度,并理想地实现自适应选择。GPT‑style effort control 就是这个方向:策略优先于算力投入(policy over compute),而不是简单的二元开关。
3. 为什么 Anthropic 的方向是一种有益的校正
推理应由目标工作负载塑形,强调工具与长任务。
背景说明
Anthropic 围绕 Claude 3.7 和 Claude 4 的公开表述相当克制。他们强调一体化推理、用户可控的思维预算、真实世界任务、代码质量,以及在延长思维过程中使用工具的能力。Claude 3.7 被定位为具备可控预算的混合推理模型;Claude 4 则进一步实现了推理与工具使用的交错,同时明确将编码、长时任务和智能体工作流作为核心目标。
核心判断
生成更长的推理轨迹,并不会自动让模型更智能。
在许多情况下,过度显性的推理反而暴露了资源分配的薄弱。如果模型试图用同样冗长的方式推理所有问题,往往意味着它未能合理设定优先级、未能有效压缩信息,或未能及时采取行动。Anthropic 的发展轨迹体现出一种更有纪律性的观点:思考应由目标工作负载塑形。如果目标是编码,那么思考应服务于代码库导航、规划、分解、错误恢复和工具编排;如果目标是智能体工作流,那么思考应提升长时程执行质量,而不是产出令人印象深刻的中间文本。
转向智能体
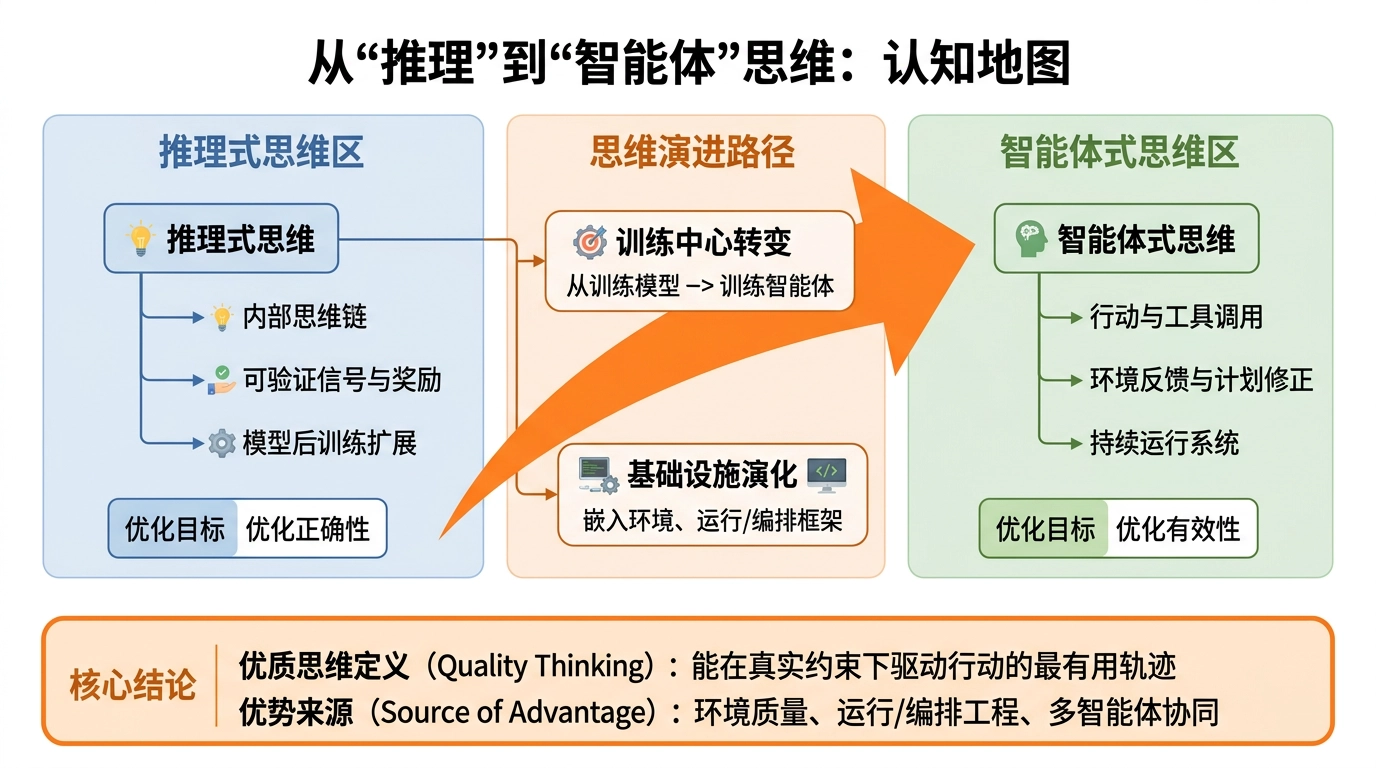
这种对目标效用的强调指向了更大的转变:我们正从训练模型的时代迈向训练智能体的时代。我们在 Qwen3 博客中对此有明确表述:“我们正从以训练模型为中心的时代,过渡到以训练智能体为中心的时代”,并将未来 RL 的进展与长时程推理中的环境反馈紧密关联。智能体是能够制定计划、决定何时行动、使用工具、感知环境反馈、修正策略并在长时程中持续运行的系统,其本质是与世界的闭环交互。
4. “智能体式思维(agentic thinking)”的真正含义
评估从“能想多久”转向“能为行动思考”。
问题定义
智能体式思维(agentic thinking)是一个完全不同的优化目标。“reasoning thinking”(推理式思维)通常以最终答案前的内部推理质量为评判标准:模型能否证明定理、写出证明、生成正确代码或通过基准测试。而智能体式思维关注的是模型能否在与环境交互的过程中持续取得进展。
核心判断
核心问题从“模型能否思考足够久?”转变为“模型能否以支撑有效行动的方式进行思考?”智能体式思维需要应对纯推理模型大多可以回避的若干挑战:
- 决定何时停止思考并采取行动
- 选择调用哪种工具及其顺序
- 融合来自环境的噪声或部分观测
- 在失败后修正计划
- 在多轮、多次工具调用中保持连贯性
智能体式思维是一种通过行动进行推理的模型。
5. 为什么智能体式 RL 基础设施更难
交互式任务改变 RL 堆栈,环境成为一等公民。
系统变化
一旦目标从解决基准问题转向解决交互式任务,RL 堆栈也随之变化。传统推理型 RL 所用的基础设施已不再足够。在推理型 RL 中,通常可以将 rollout(回放)视为相对独立的轨迹,并配合较为干净的评测器。而在智能体式 RL 中,策略嵌入在更大的运行/编排框架(harness)中:工具服务、浏览器、终端、搜索引擎、模拟器、执行沙箱、API 层、记忆系统和编排框架。环境不再只是静态验证器,而是训练系统的一部分。
新的系统需求
这带来了新的系统需求:训练与推理必须更加彻底地解耦。否则,rollout 吞吐量会大幅下降。以一个需要在实时测试运行/编排框架中执行生成代码的编码智能体为例:推理端因等待执行反馈而阻塞,训练端因缺乏完整轨迹而“断粮”,整个流水线的 GPU 利用率远低于传统推理型 RL。工具延迟、部分可观测和有状态环境进一步放大了这些低效,导致实验进展极慢,远未达到目标能力水平时就已变得异常痛苦。
环境成为核心能力
环境本身也成为一等研究对象。
在 SFT(监督微调)时代,我们极度关注数据多样性;而在智能体时代,我们应当极度关注环境质量:稳定性、真实度、覆盖度、难度、状态多样性、反馈丰富度、抗利用性、回放可扩展性。环境构建已开始成为一个真正的创业赛道,而不仅仅是附属项目。如果智能体被训练用于类生产环境,那么环境就是核心能力栈的一部分。
6. 下一阶段的前沿是更可用的思维
工具增强与防作弊并重,走向系统级智能体。
方向判断
我们预期,智能体式思维(agentic thinking)将成为主流思维形态。我认为,它最终可能会取代大量传统的静态独白式“reasoning thinking”(推理式思维):那种过度冗长、孤立的内部推理轨迹,试图通过不断输出更多文本来弥补缺乏交互的问题。即便是在极难的数学或编程任务中,真正先进的系统也应具备搜索、模拟、执行、检查、验证和修正的能力,其目标是以稳健且高效的方式解决问题。
风险、限制、失败点、坑点
训练此类系统最艰难的挑战是奖励作弊(reward hacking)。
一旦模型获得有意义的工具访问权限,奖励作弊的风险就会显著增加。具备搜索能力的模型可能在 RL 过程中直接查找答案;编码智能体可能利用代码库中的未来信息、滥用日志或发现能绕过任务的捷径;环境中若存在隐蔽漏洞,策略看似超越人类,实则是在训练作弊行为。这正是智能体时代比推理时代更为敏感和复杂的地方。更强大的工具让模型更有用,但同时也扩大了伪优化的攻击面。我们应预见,下一阶段的研究瓶颈将主要来自环境设计、评测器稳健性、反作弊协议,以及策略与现实世界之间更规范的接口。尽管如此,方向依然明确:工具增强的思维远比孤立思维更有用,也更有可能提升实际生产力。
系统与工程
智能体式思维还意味着运行/编排框架(harness)工程。核心智能将越来越依赖于多个智能体的组织方式:包括负责规划与调度的编排器、如领域专家般行动的专家型智能体,以及执行更窄任务、协助控制上下文、避免污染、保持不同推理层次分隔的子智能体。未来将从训练模型转向训练智能体,再从训练智能体转向训练系统。
结论
从推理到智能体,竞争焦点转向环境与编排。
推理浪潮的第一阶段确立了一个重要事实:在语言模型之上应用 RL,只要反馈信号可靠且基础设施能够支撑,就能带来质的认知提升。
更深层的转变,是从“reasoning thinking”(推理式思维)到智能体式思维(agentic thinking):从更长时间的思考,转向为了行动而思考。训练的核心对象已经发生转移——如今的重点是模型+环境系统,更具体地说,是智能体及其运行/编排框架(harness)。这改变了哪些研究成果最为关键:模型架构和训练数据固然重要,但环境设计、回放(rollout)基础设施、评测器稳健性,以及多智能体协同的接口同样成为核心要素。这也重塑了“优质思维”的定义:不再是最长或最显眼的推理轨迹,而是能在真实世界约束下持续驱动行动的最有用轨迹。
同时,这也改变了竞争优势的来源。在推理时代,优势来自更优的 RL 算法、更强的反馈信号,以及更具扩展性的训练流程。在智能体时代,优势将来自更高质量的环境、更紧密的训练与服务一体化、更强的运行/编排工程能力,以及能够闭环连接模型决策与实际结果的能力。
讨论
登录后可评论、点赞、引用回复。